- IT (1792)

오늘도 공부
새로 나온 구글 임베딩 모델 EmbeddingGemma 2 직접 뜯어보기 본문
휴대폰 사진첩에서 길을 잃은 적 있으신가요
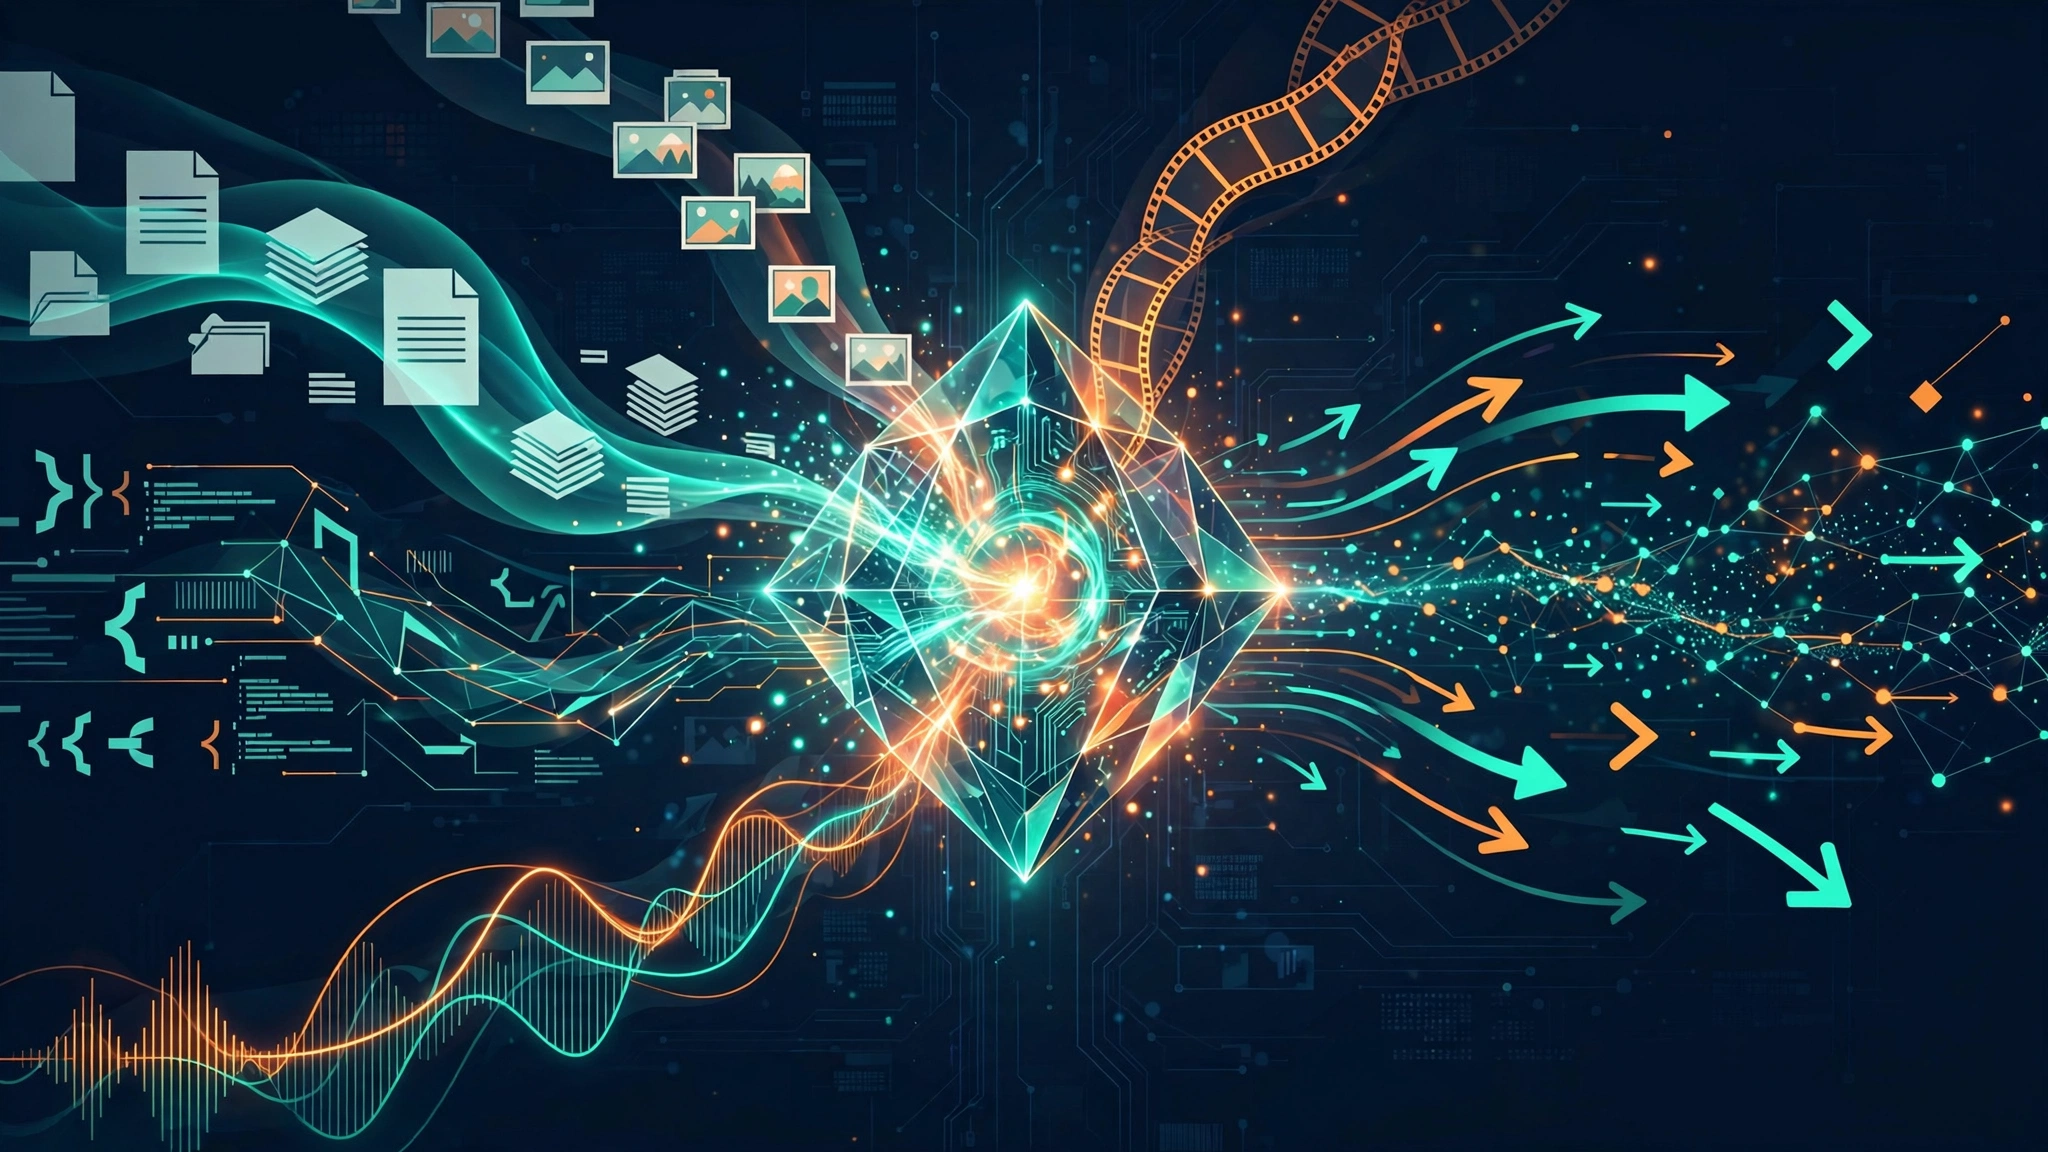
휴대폰 사진첩에 사진이 10,000장 있습니다. "작년 여름, 아이들이 바닷가에서 뛰어놀던 사진"을 찾고 싶어요. 파일명으로 검색해도 안 나오고, 태그를 달아둔 적도 없습니다. 그날의 파일명이 IMG_4829.jpg였는지 누가 기억하나요.
그래서 보통은 포기합니다. 스크롤을 끝없이 내리다가 "아, 이거다" 하고 멈추는 식으로요.
며칠 전 Google이 공개한 EmbeddingGemma 2는, 이 포기 지점을 없애려는 모델입니다. SNS에서는 "유저 100만 명이어도 서버비 0원" 같은 말과 함께 돌고 있는데, 오늘은 그 말이 어디까지 진짜인지 공식 자료를 바탕으로 하나씩 짚어보려 합니다.
EmbeddingGemma 2는 ChatGPT처럼 답변을 만드는 AI가 아니라, 텍스트·코드·사진·영상·음성을 모두 '같은 의미 공간의 터'로 바꿔주는 초경량 검색 AI입니다.
그리고 이 변환을 서버가 아니라 스마트폰·노트북·브라우저에서 할 수 있다는 것. 그게 이번 발표의 진짜 포인트입니다.
사진 한 장은 숫자 768개가 된다
EmbeddingGemma 2는 사진 자체를 보고 숫자 768개의 벡터로 바꿉니다. 검색어 "아이들이 바닷가에서 뛰는 사진"도 똑같이 벡터로 바꾸고요. 두 벡터가 가까우면(Similarity = 0.94) 같은 의미라고 판단합니다.
파일명도 태그도 필요 없습니다. 사진의 내용을 보고 찾는 거예요.
실제로 Google의 AI Edge Gallery도 사진과 비디오를 임베딩해서 SQLite에 로컬로 저장한 뒤, cosine similarity로 검색합니다. 인터넷 없이도 돌아갑니다.
다섯 개의 길이 하나로 합쳐진다
이번 모델에서 제가 가장 재미있게 본 부분입니다.
예전에는 모달리티마다 모델이 따로 필요했습니다. 텍스트는 text embedding model, 이미지는 CLIP, 오디오는 Whisper를 거쳐 text embedding으로, 비디오는 프레임을 뽑아 image embedding으로. 각자 다른 공간에 살고 있었죠.
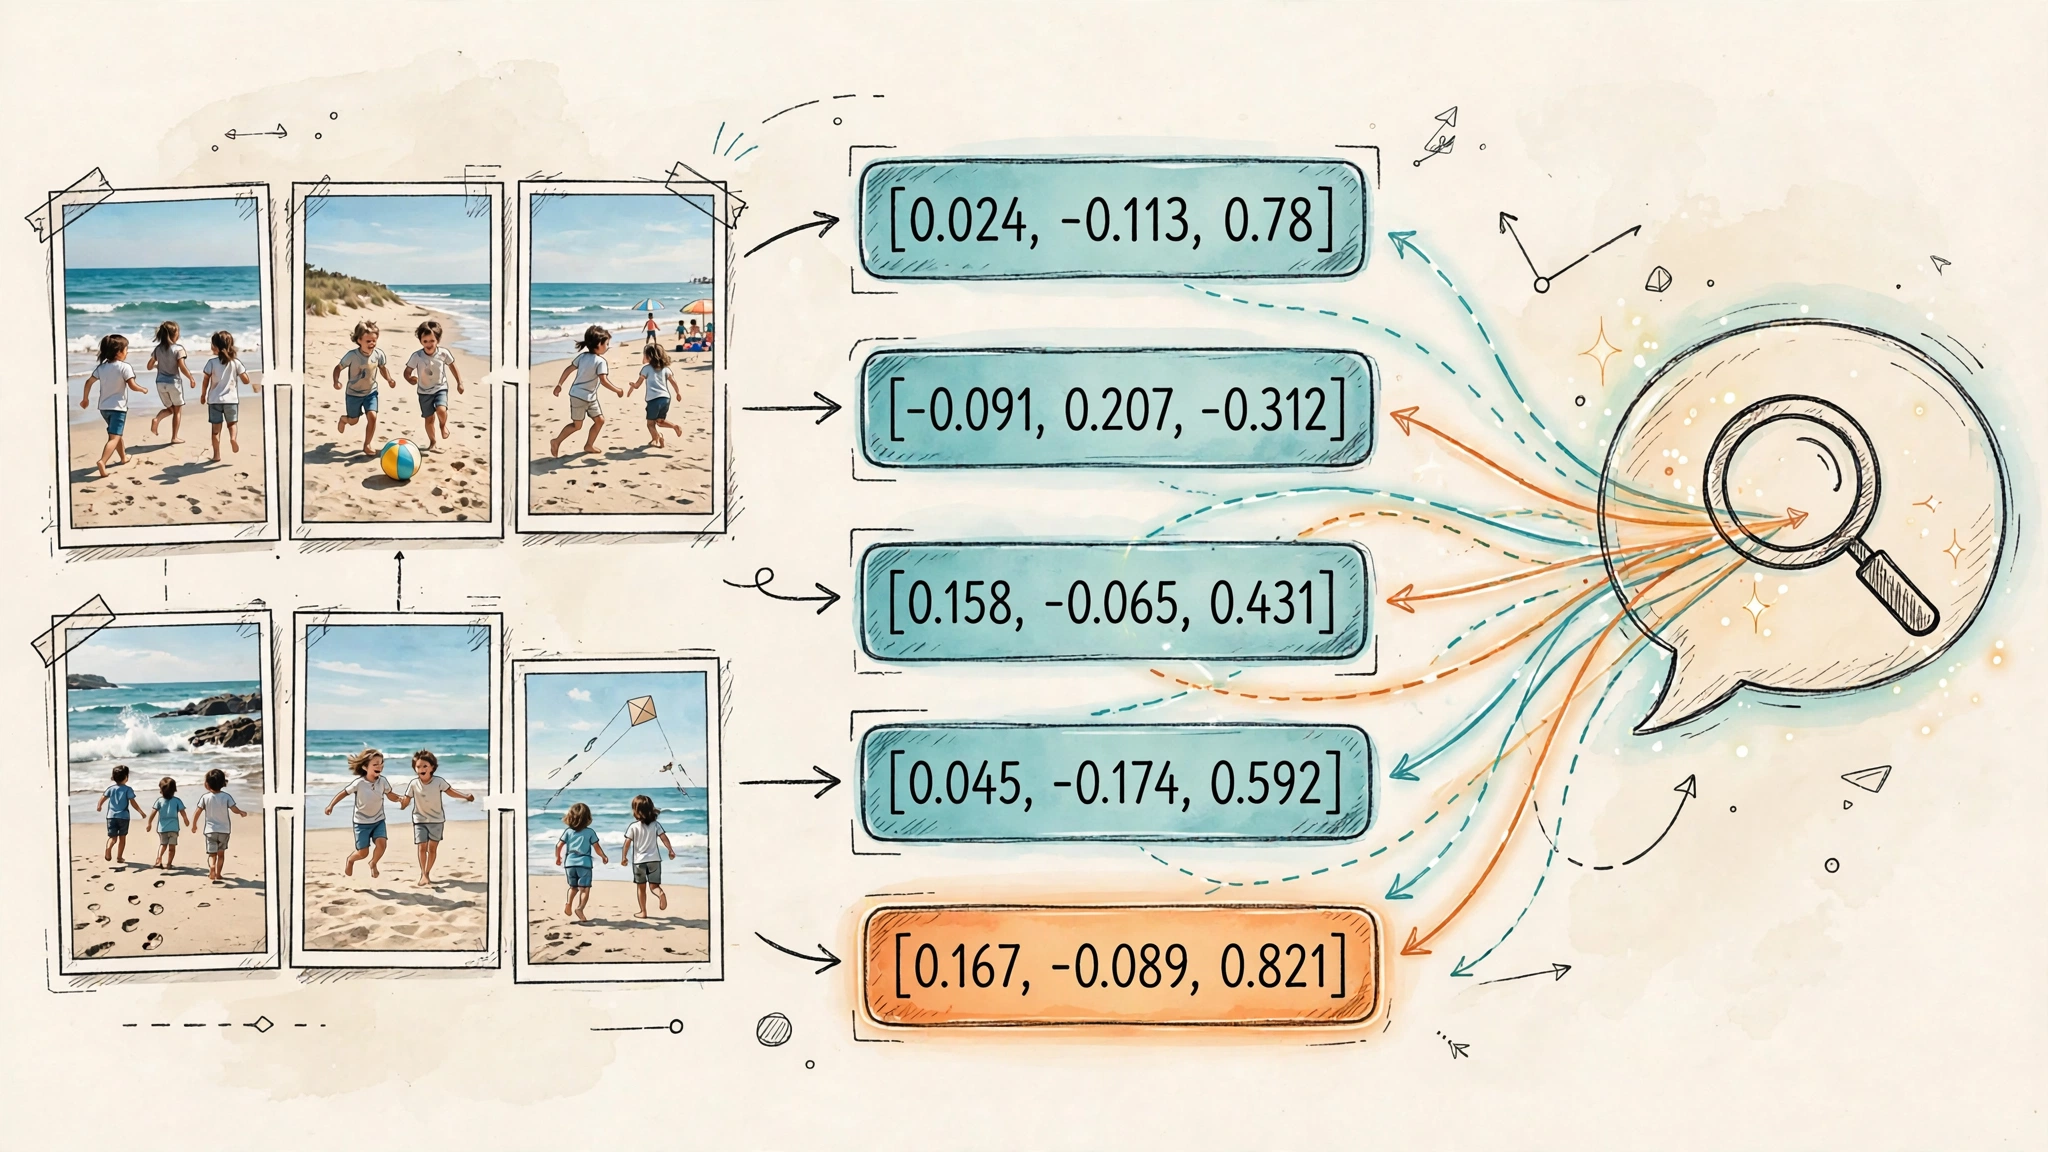
EmbeddingGemma 2는 텍스트, 코드, 이미지, 비디오, 오디오를 전부 같은 768차원 공간 하나로 처리합니다.
그래서 이런 일이 가능해집니다. 검색어 "노을지는 바다에서 파도 소리가 나는 영상" 하나를 임베딩하면, 사진·영상·음성·텍스트·문서를 전부 동시에 검색할 수 있어요.
음성 "자동차 엔진 소리"로 비디오 2분 13초 지점의 자동차 출발 장면을 찾는 것 같은, 음성에서 영상으로 바로 건너뛰는 검색도 됩니다. Google이 공식 대표 사례로 "voice memo로 특정 video clip 찾기"를 든 이유입니다.
740M인데 왜 '초경량'이라고 부를까
전체 모델은 740M 파라미터입니다. 하지만 항상 다 로드할 필요는 없습니다. 필요한 것만 골라 올리면 되거든요.
텍스트와 코드만 필요하면 270M, 텍스트에 이미지·비디오까지면 440M, 텍스트에 오디오까지면 570M, 전체 멀티모달을 다 쓰면 740M. 코드 검색 앱이라면 270M만, 사진 검색 앱이라면 440M만 올리는 식입니다. 꽤 영리한 설계예요.
"191MB"라는 숫자에 붙은 작은 별표
SNS에서 도는 191MB 이야기는 사실입니다. 다만 별표가 붙어요.
Google 테스트 기준(Pixel 11 Pro, quantization 적용)에서 텍스트 전용 구성은 약 191MB Active RAM, 전체 멀티모달은 약 567MB입니다.
그러니까 "EmbeddingGemma 2 전체가 RAM 191MB"는 틀린 말이고, 정확히는 "텍스트 전용 quantized 구성에서 최소 약 191MB"입니다. 참고로 Google은 INT4/INT8 Quantization-Aware Training을 적용하고 있어요.
러시아 인형처럼 차원을 깎아낸다
기본 벡터는 768차원인데, Matryoshka Representation Learning(MRL) 덕분에 768에서 512, 256, 128로 잘라서 쓸 수 있습니다. 앞쪽 차원에 중요한 정보를 몰아넣고 학습했기 때문에 뒤를 잘라내도 쓸 만한 거죠. 러시아 인형 같다고 해서 붙은 이름입니다.
저장 공간도 확 줄어듭니다. 100만 개 벡터를 bfloat16으로 저장하면 768차원은 약 1.5GB, 128차원은 약 250MB. 여섯 배 차이예요.
잠깐, 128차원이 "품질 저하 없음"은 아니다
여기가 SNS 설명에서 꼭 바로잡아야 할 부분입니다.
공식 권장 기준은 대략 이렇습니다. 768과 512는 최고 품질이라 멀티모달 검색에 권하고, 256은 상당히 좋은 절충점이라 저장 공간을 3분의 1로 줄이고 싶을 때 쓰고, 128은 대규모 텍스트 검색이나 1차 후보 추출용입니다.
Google은 256차원에서는 원래 품질을 대부분 유지하지만, 128차원에서는 이미지·영상·음성 검색 품질이 더 크게 떨어진다고 명시합니다. 실전에서는 256차원을 기본값으로 시작하시는 걸 권합니다.
Pinecone이 사라진다는 말에 대하여
개인 로컬 AI 앱에서는 상당 부분 맞는 말입니다.
사진 2만 장, 메모 5천 개, PDF 천 개, 음성 메모 500개를 가진 사용자 한 명을 생각해 보죠. 기존 구조는 폰에서 서버로 올리고, Embedding API를 거쳐 Pinecone에서 검색해 다시 폰으로 돌려주는 방식이라 사용자가 늘수록 API 비용, Vector DB 비용, 네트워크 비용, 서버 비용이 전부 올라갑니다.
EmbeddingGemma 2 방식은 폰 안에 모델과 SQLite, 벡터 검색을 전부 로컬로 둡니다. 클라우드를 거치지 않아요.
하지만 1억 개 상품이나 전체 사용자 공유 문서, 기업 중앙 지식베이스처럼 모두가 같은 데이터를 검색해야 한다면 서버 검색 시스템은 여전히 필요합니다. 정확한 표현은 "개인 데이터 검색에서는 클라우드 Vector DB 없이도 상당히 강력한 AI 검색을 구현할 수 있다" 정도입니다.
브라우저에서 돌아간다는 것의 의미
Google 공식 발표에는 브라우저 실행 방법으로 transformers.js와 WebGPU를 명시했습니다. 웹사이트에 접속하면 브라우저 안에서 모델이 돌고, IndexedDB에 저장하고, 시맨틱 검색까지 되는 구조예요. 서버에 데이터를 올릴 필요가 전혀 없습니다.
다만 "사이트 접속 즉시"는 약간 과장입니다. 첫 실행 때는 모델 다운로드, 초기화, WebGPU 컴파일, 초기 데이터 인덱싱 때문에 시간이 걸려요. 두 번째부터는 캐시 덕분에 빨라집니다. 저사양 스마트폰에서는 성능이 떨어질 수 있다는 점도 감안해야 하고요.
그래서 뭘 만들 수 있는데
몇 가지 그림을 그려봤습니다.
먼저 AI 사진첩. "작년 여름 아이들이 바닷가에서 뛰던 사진"이라고 검색하면 로컬 벡터와 비교해 찾아줍니다. 인터넷 필요 없습니다.
음성으로 영상 찾기도 됩니다. "강아지가 뛰어오는 장면"이라고 말하면 영상 전체에서 34초, 2분 13초, 7분 42초 같은 후보 구간을 찾아줘요. Google은 Video Moments Finder 데모도 제공합니다.
개인 코드 검색도 재밌습니다. GitHub 프로젝트를 로컬에서 인덱싱해 두고 "JWT 토큰 검증하는 코드 어디 있지?"라고 물으면 auth.ts나 jwt.service.ts를 의미 기반으로 찾아줍니다. MTEB Code 점수가 68.76에서 78.68로 크게 올랐어요.
개인 RAG도 가능합니다. PDF와 메모, 사진, 녹음을 로컬에 저장해 두고 "지난번 자동차 보험 관련 자료 찾아줘"라고 하면 관련 자료를 찾아 LLM에게 넘기는 거죠. Google도 Gemma 4와 EmbeddingGemma 2를 결합한 on-device RAG를 주요 활용법으로 설명합니다.
이 모델이 "생각"하지 않는다는 것
하나만 분명히 해둘게요. "이 PDF 읽고 천 자로 보고서 써줘" 같은 건 이 모델이 못 합니다.
EmbeddingGemma 2의 일은 PDF 천 개 중에서 질문과 관련된 다섯 개를 찾아 LLM에게 전달하는 것까지예요. 찾아주는 AI와 생각해서 써주는 AI는 역할이 다릅니다.
"비용 0원"이라는 말의 정확한 번역
Static Web App에 EmbeddingGemma 2, WebGPU, IndexedDB를 올리면 Embedding API도, Vector DB도, 추론 서버도 0원이 됩니다. 이건 사실이에요.
다만 로그인, 클라우드 동기화, 대용량 파일 저장, 공유 데이터, LLM API, 결제, 푸시, 분석이 필요해지는 순간 서버 비용은 다시 발생합니다.
그래서 정확한 번역은 이렇습니다. "EmbeddingGemma 2 덕분에 AI 검색·추천·분류 같은 기능의 추론 비용을 사용자 기기로 넘길 수 있다."
개발자라면 이 기능을 보세요
검색 얘기는 많이 나왔으니, 다른 하나를 소개합니다. Decision Engine이라는 활용법이에요.
사용자 메시지 "이번 주 토요일 서울행 KTX 찾아줘"를 미리 만들어 둔 벡터들, 예약, 검색, 결제, 환불, 고객센터와 비교하면 검색 0.92, 예약 0.81, 고객센터 0.12 같은 결과가 나옵니다.
LLM을 부르지 않고도 의도 분류와 도구 라우팅이 가능하다는 뜻입니다. Google은 한 번에 500개 옵션을 평가하는 작업을 100ms 안에 끝낸 사례를 공개했어요. 개인적으로는 검색보다 에이전트 개발자에게 더 흥미로운 기능이라고 봅니다.
코드는 생각보다 짧습니다
Python에서 텍스트 검색은 sentence_transformers로 모델을 불러와 encode에 문서를 넣는 정도면 됩니다. 공식 가이드의 방식 그대로, 문서에는 Document 프롬프트를, 검색어에는 SearchQuery 프롬프트를 쓰고, 차원은 256으로 자르고 정규화하는 식이죠. 그 다음 cosine similarity로 가장 가까운 문서를 찾으면 끝입니다.
멀티모달도 어렵지 않습니다. 이미지 파일 하나, 오디오 파일 하나를 각각 encode하고, 검색어도 encode해서 서로 바로 비교할 수 있어요. 텍스트와 이미지와 비디오를 하나의 embedding으로 만드는 interleaved 입력 예제도 공식 개발자 가이드에 있습니다.
한 번에 처리할 수 있는 양은 공식 스펙상 8192 토큰. 텍스트 8,192토큰, 이미지 약 29장, 비디오 약 58프레임, 오디오 약 327초까지 하나의 입력으로 처리됩니다. 1시간짜리 영상은 보통 10초 단위로 잘라 360개 벡터로 만들고, "강아지가 물에 뛰어드는 장면"으로 2분 41초 지점을 찾는 구조가 됩니다.
마무리하며
SNS에서 도는 "AI 앱 서버비가 완전히 사라졌다"는 말은 이렇게 고쳐 쓰고 싶습니다.
AI 검색의 서버가 사라질 수 있게 됐다.
텍스트와 코드, 사진, 영상, 음성을 같은 벡터 공간으로 변환하고, 그걸 스마트폰이나 브라우저에서 직접 실행할 수 있다. 임베딩 API와 클라우드 벡터 DB 없이도 개인의 검색과 추천, 분류, RAG 검색을 완전 로컬로 구현할 수 있다는 점. 그게 이번 발표의 핵심입니다.
이 글의 수치와 스펙은 Google DeepMind 공식 발표와 Hugging Face 모델카드, Google 개발자 가이드를 바탕으로 정리했습니다. 공식 자료: Google DeepMind 발표 · Hugging Face 모델 · Google 개발자 가이드
'AI' 카테고리의 다른 글
| AI 시대의 개발자의 다음 역할인 AI Builder? (0) | 2026.10.06 |
|---|---|
| AI가 코드를 다 짜는 시대, 엔지니어는 무엇을 공부해야 할까 (0) | 2026.09.15 |
| Microsoft가 말하는 ‘에이전트 시대 개발자의 새로운 규칙’ (0) | 2026.09.14 |
| GPT-6 Astra 프롬프트 작성법 (0) | 2026.09.09 |
| MiniMax H3 Max Turbo로 5초 영상 생성 시간 2초 (0) | 2026.09.04 |
